راهنمای انتخاب مدلهای هوش مصنوعی در ۲۰۲۶؛ کدام مدل برای چه کاری مناسب است؟
تا همین چند سال پیش، انتخاب یک مدل هوش مصنوعی کار چندان پیچیدهای نبود. چند مدل شناختهشده وجود داشتند و اغلب کاربران کافی بود بین ChatGPT، Claude یا Gemini یکی را انتخاب کنند. در سال ۲۰۲۶ اما ماجرا کاملاً فرق کرده است. حالا با خانوادههایی مثل GPT-6، Claude 5.5، Gemini 3، Grok 4، DeepSeek V4، Gemma 4 و دهها مدل تخصصی برای تصویر، ویدئو، صدا و موسیقی روبهرو هستیم.
در چنین بازاری سؤال اصلی دیگر این نیست که «بهترین مدل هوش مصنوعی کدام است؟». سؤال بهتر این است: برای کاری که من میخواهم انجام دهم، کدام مدل انتخاب منطقیتری است؟
ممکن است یک مدل در حل مسئلههای پیچیده فوقالعاده باشد اما برای خلاصهسازی روزانه صدها سند، انتخابی گران و غیرضروری محسوب شود. مدلی دیگر شاید در بنچمارکهای استدلالی صدرنشین نباشد، اما بهخاطر سرعت و قیمت پایینتر، برای یک سیستم اتوماسیون انتخاب بسیار بهتری باشد. برای تولید تصویر، ویدئو یا موسیقی هم اصولاً ممکن است استفاده از یک مدل زبانی عمومی بهترین مسیر نباشد.
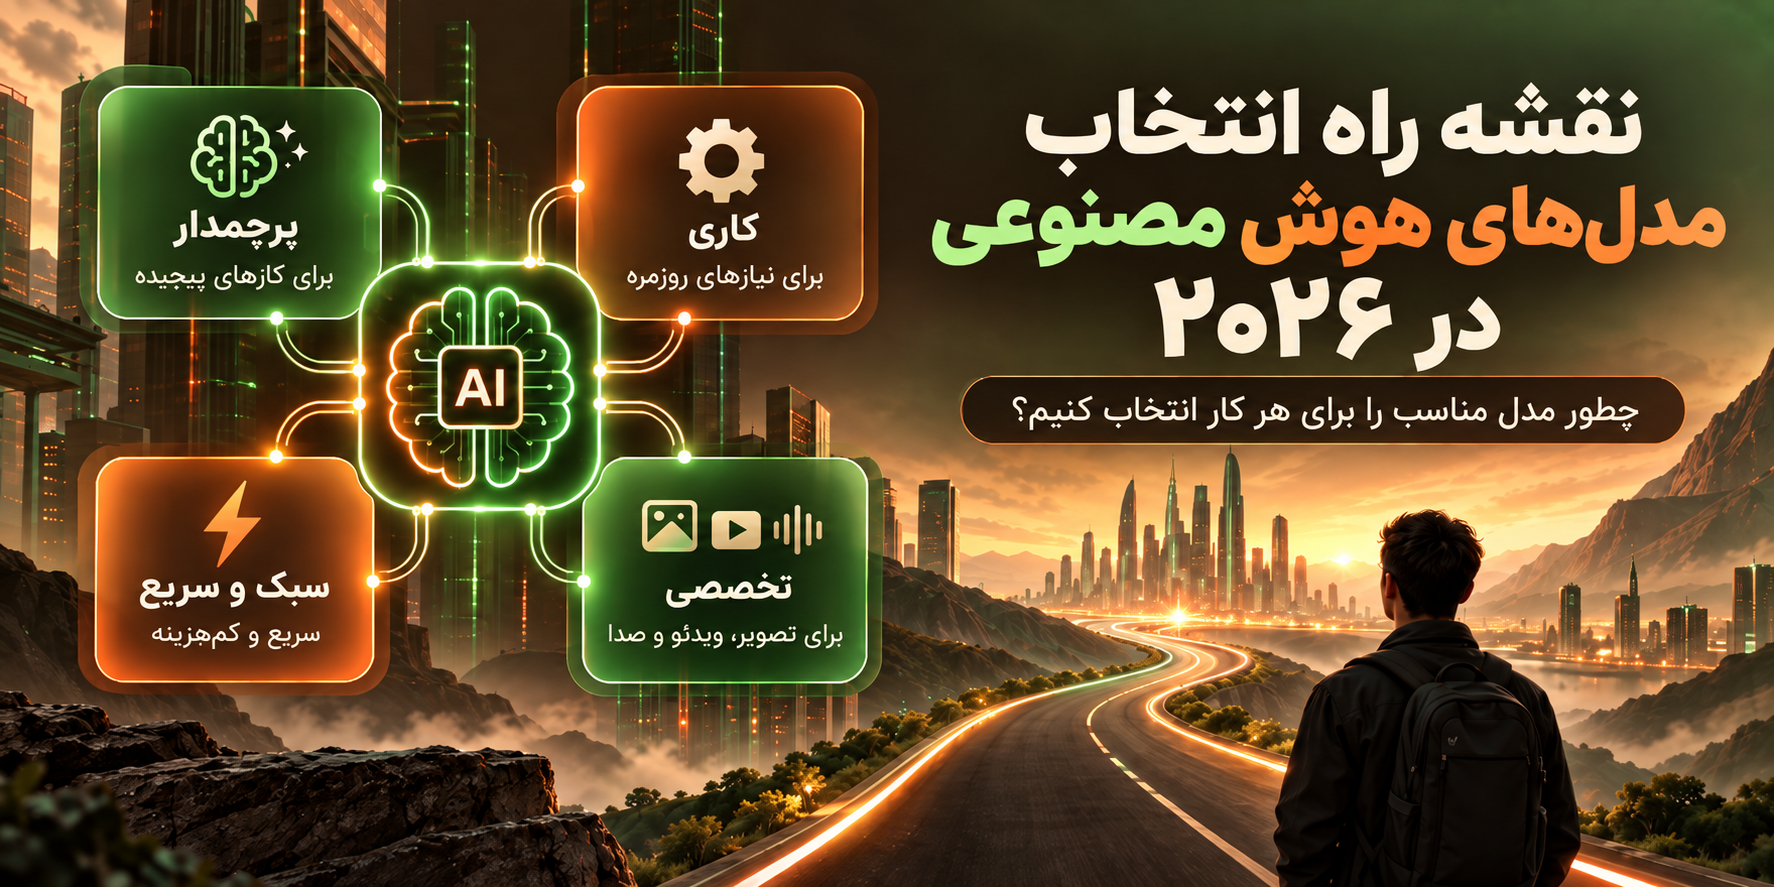
هستۀ اصلی نسخه قبلی این راهنما نیز بر همین اصل بنا شده بود: ابتدا باید نوع مسئله را مشخص کرد و سپس از میان چهار گروه کلی پرچمدار، کاری، سبک و سریع و تخصصی، ابزار مناسب را انتخاب کرد. این منطق همچنان معتبر است؛ چیزی که تغییر کرده، مدلهایی است که در هر دسته قرار میگیرند و میزان توانایی آنهاست.
در ادامه، نقشه راه بهروز انتخاب مدلهای هوش مصنوعی در سال ۲۰۲۶ را بررسی میکنیم.
قانون اصلی در ۲۰۲۶: مدل را براساس کار انتخاب کنید، نه شهرت آن
سرعت پیشرفت مدلهای هوش مصنوعی باعث شده مفهوم «بهترین مدل» بیش از گذشته وابسته به نوع استفاده باشد. حتی شرکتهای سازنده هم دیگر یک مدل واحد برای تمام نیازها عرضه نمیکنند. OpenAI خانواده GPT-6 را در سطوح مختلف Astra، Sol و Luna ارائه میکند؛ Anthropic میان Opus و Sonnet و مدلهای سبکتر تمایز میگذارد و Google نیز خانوادههای Pro، Flash و Flash-Lite را برای نیازهای متفاوت توسعه داده است.
این ساختار یک پیام ساده دارد: هرچه مدل قدرتمندتر باشد، الزاماً برای شما مناسبتر نیست.
فرض کنید میخواهید روزانه هزاران توضیح محصول را طبقهبندی کنید. استفاده از گرانترین مدل موجود احتمالاً هزینه زیادی ایجاد میکند بدون اینکه تفاوت کیفیت خروجی، این هزینه را توجیه کند. اما اگر قرار است یک پایگاه کد بزرگ بازطراحی شود، یک گزارش پیچیده از چندین منبع تهیه کنید یا یک Agent چندین مرحله کار را مستقل انجام دهد، پرداخت هزینه بیشتر برای یک مدل پرچمدار میتواند منطقی باشد.
برای همین، میتوان مدلهای هوش مصنوعی فعلی را از نظر کاربرد در چهار گروه اصلی قرار داد:
| رده مدل | مناسب برای | اولویت اصلی | نمونههای فعلی |
|---|---|---|---|
| پرچمدار یا Frontier | مسائل پیچیده، پژوهش، کدنویسی سنگین و Agentهای پیشرفته | حداکثر توانایی | GPT-6 Astra، Claude Opus 5.5، Gemini 3.1 Pro Preview |
| کاری یا Workhorse | بخش بزرگی از کارهای روزمره حرفهای | تعادل کیفیت، سرعت و هزینه | GPT-6 Sol، Claude Sonnet 5.5، Gemini 3.8 Flash، Grok 4.7 |
| سبک و سریع | اتوماسیون، پردازش انبوه و کارهای تکراری | سرعت و هزینه | GPT-6 Luna، DeepSeek V4.1 Flash، Mistral Small 4 |
| تخصصی | تصویر، ویدئو، صدا و موسیقی | کیفیت در یک وظیفه مشخص | GPT-Image 2.5، Nano Banana، Veo، Suno و مدلهای مشابه |
یک نکته را هم باید از ابتدا روشن کنیم: این دستهبندی مرزهای کاملاً ثابتی ندارد. بعضی مدلهای هوش مصنوعی جدید آنقدر توانمند شدهاند که میتوانند همزمان در دو گروه قرار بگیرند. Gemini 3.8 Flash نمونه خوبی است؛ نام Flash معمولاً یادآور مدلی سریع و اقتصادی است، اما Google این نسخه را برای مهندسی نرمافزار طولانیمدت، Agentها و فرایندهای پیچیده سازمانی نیز توسعه داده است.
دسته اول: مدلهای هوش مصنوعی پرچمدار؛ وقتی مسئله واقعاً سخت است
مدلهای پرچمدار یا Frontier برای زمانی ساخته شدهاند که کیفیت پاسخ، توانایی استدلال، کار با ابزارها و حفظ انسجام در وظایف طولانی مهمتر از هزینه هر درخواست است.
این همان جایی است که استفاده از یک مدل بزرگتر واقعاً میتواند تفاوت ایجاد کند. تحلیل یک مسئله مبهم، مهاجرت یک پروژه نرمافزاری بزرگ، پژوهش چندمرحلهای، کار با دهها منبع، برنامهریزی پیچیده یا اجرای یک Agent برای مدت طولانی، نمونههایی از چنین کاربردهایی هستند.
GPT-6 Astra؛ پرچمدار OpenAI
در سپتامبر ۲۰۲۶، OpenAI مدل GPT-6 Astra را بهعنوان قدرتمندترین مدل عمومی خود معرفی کرد. این مدل برای کارهایی مانند استفاده از کامپیوتر، وبگردی، مهندسی نرمافزار، پژوهش علمی و وظایف حرفهای پیچیده توسعه یافته و از طریق ChatGPT و API ارائه میشود. قیمت استاندارد API آن برای کانتکست کوتاه، ۱۰ دلار بهازای هر یک میلیون توکن ورودی و ۵۰ دلار برای خروجی اعلام شده است.
Astra انتخاب مناسبی برای این نیست که از آن بخواهید یک ایمیل کوتاه بنویسد یا چند تگ برای مقاله پیشنهاد کند. ارزش چنین مدلی زمانی مشخص میشود که مسئله آنقدر پیچیده باشد که افزایش کیفیت تصمیمگیری یا کاهش خطا، هزینه بالاتر را توجیه کند.
به زبان ساده، GPT-6 Astra را باید بیشتر شبیه یک متخصص ارشد در نظر گرفت تا دستیار روزمره.
Claude Opus 5.5؛ مدل سنگین Anthropic برای کارهای پیچیده
Anthropic در ۲۲ سپتامبر ۲۰۲۶ Claude Opus 5.5 را معرفی کرد. این شرکت Opus 5.5 را برای کدنویسی Agentic، کارهای دانشی پیچیده و وظایفی عرضه کرده که به قضاوت و پیگیری طولانی نیاز دارند. قیمت API نیز به ۴ دلار برای هر یک میلیون توکن ورودی و ۲۰ دلار برای خروجی رسیده است. Anthropic اعلام کرده این نسخه در بارهای کاری معمول حدود ۴۰ درصد هزینه کمتری نسبت به Opus 5 ایجاد میکند.
نکته جالب این است که خود Anthropic هم درباره تفسیر بیشازحد بنچمارکها هشدار داده و میگوید با نزدیکترشدن توانایی مدلهای پیشرفته، اختلاف چند امتیازی در یک آزمون همیشه تفاوت واقعی آنها در پروژه شما را نشان نمیدهد.
این نکته برای انتخاب همه مدلهای هوش مصنوعی مهم است: بنچمارک را ببینید، اما تصمیم نهایی را با آزمون روی وظیفۀ واقعی خودتان بگیرید.
Gemini 3.1 Pro؛ مدل پیشرفته Google، اما هنوز Preview
در اکوسیستم Google، Gemini 3.1 Pro همچنان مدل Pro پیشرفتهای است که برای حل مسئله پیچیده، مهندسی نرمافزار و Workflowهای Agentic طراحی شده است. این مدل از ورودی متن، تصویر، ویدئو، صوت و PDF پشتیبانی میکند و پنجره کانتکست آن بیش از یک میلیون توکن است. با این حال، تا زمان نگارش این مقاله همچنان با برچسب Preview ارائه میشود.
بنابراین اگر محیط تولیدی شما به ثبات نسخه اهمیت زیادی میدهد، صرفاً دیدن نام Pro نباید باعث شود گزینههای پایدارتر Google را کنار بگذارید.
دسته دوم: مدلهای Workhorse؛ احتمالاً همان چیزی که بیشتر کاربران نیاز دارند
در عمل، بخش بزرگی از کارهایی که با هوش مصنوعی انجام میدهیم نیازی به قویترین مدل موجود ندارد.
نوشتن و ویرایش محتوا، تحلیل فایل، ساخت گزارش، تحقیق، برنامهنویسی معمول، رفع باگ، ساخت اسلاید، کار با دادهها، استفاده از ابزارها و بسیاری از وظایف حرفهای را میتوان با یک مدل Workhorse خوب انجام داد.
اتفاق مهم سال ۲۰۲۶ این است که کیفیت این دسته از مدلهای هوش مصنوعی بسیار بالا رفته و فاصله آنها با مدلهای پرچمدار در بسیاری از کارهای روزمره کمتر شده است.
GPT-6 Sol؛ مدل اصلی برای کارهای پیچیده روزمره
در خانواده جدید OpenAI، GPT-6 Sol نقش مدل کاری را دارد. قیمت استاندارد API آن برای کانتکست کوتاه ۲ دلار برای هر یک میلیون توکن ورودی و ۱۰ دلار برای خروجی است؛ یعنی هزینه آن بهمراتب پایینتر از Astra است.
برای توسعه نرمافزار، پژوهش، تحلیل، تولید محتوای حرفهای و Workflowهایی که به توانایی بالا نیاز دارند اما الزاماً سختترین مسئله ممکن نیستند، مدلی در این سطح معمولاً نقطه شروع منطقیتری است.
Claude Sonnet 5.5؛ یکی از تازهترین تغییرات بازار
یکی از جدیدترین تغییرات این مقاله درست در روز انتشار نسخۀ بهروزشده آن اتفاق افتاده است. Anthropic در ۲۸ سپتامبر ۲۰۲۶ Claude Sonnet 5.5 را منتشر کرد؛ مدلی که قرار است نقش Workhorse خانواده Claude را برای کارهای نسبتاً مشخص روزمره، ساخت و ویرایش اسناد، کدنویسی، رفع باگ و کار با ابزارها ایفا کند.
قیمت API آن مانند Sonnet 5 روی ۲ دلار بهازای هر یک میلیون توکن ورودی و ۱۰ دلار برای خروجی باقی مانده، اما Anthropic میگوید مدل جدید برای انجام یک کار معمولاً توکن و Tool Call کمتری مصرف میکند. GitHub نیز Sonnet 5.5 را همان روز برای Copilot عرضه کرد و آن را برای کارهای روزمره مشخص مانند ساخت قابلیت و رفع باگ معرفی کرده است.
برای بسیاری از کاربران حرفهای، همین رده از مدلهای هوش مصنوعی احتمالاً از نظر نسبت توانایی به هزینه منطقیتر از رفتن مستقیم سراغ مدل پرچمدار است.
Gemini 3.8 Flash؛ وقتی «Flash» دیگر به معنی مدل ساده نیست
Google در ۲ سپتامبر ۲۰۲۶ Gemini 3.8 Flash را بهصورت پایدار و آماده استفاده در محیط Production منتشر کرد. مدل از بیش از یک میلیون توکن کانتکست، ورودی متن، تصویر، ویدئو، صوت و PDF و ابزارهایی مثل Function Calling، جستوجو، اجرای کد و Computer Use در حالت Preview پشتیبانی میکند.
قیمت مقدماتی API آن تا ۳۱ دسامبر ۲۰۲۶ برابر ۰٫۷۵ دلار برای هر یک میلیون توکن ورودی و ۳٫۷۵ دلار برای خروجی است. Google اعلام کرده از ابتدای ۲۰۲۷ قیمت استاندارد بالاتر خواهد رفت.
برای تحلیل اسناد بزرگ، ورودیهای چندرسانهای، پردازش ویدئو، توسعه Agent و پروژههایی که به کانتکست بسیار طولانی نیاز دارند، Gemini 3.8 Flash یکی از گزینههایی است که ارزش بررسی دارد.
Grok 4.7؛ مدل جدید xAI برای کد و کار دانشی
Grok 4.7 در ۲۱ سپتامبر ۲۰۲۶ عرضه شد. xAI این مدل را برای کدنویسی، Agentها و Knowledge Work معرفی کرده است. پنجره کانتکست آن ۵۰۰ هزار توکن و قیمت API زیر مرز ۲۰۰ هزار توکن، ۲ دلار برای ورودی و ۶ دلار برای خروجی بهازای هر یک میلیون توکن است. مدل از ورودی تصویر نیز پشتیبانی میکند.
یک سوءبرداشت رایج درباره Grok این است که هر پاسخ آن بهصورت خودکار به دادههای لحظهای X یا وب متصل است. مستندات xAI تصریح میکنند که برای دسترسی به دادههای بهروز باید ابزار Web Search یا X Search فعال باشد.
دسته سوم: مدلهای سبک و سریع؛ جایی که هزینه و مقیاس اهمیت پیدا میکند
اگر قرار است یک درخواست را پنج بار در روز اجرا کنید، اختلاف قیمت مدلها شاید چندان مهم نباشد. اما اگر همان درخواست روزانه صد هزار بار اجرا شود، انتخاب مدل هوش مصنوعی میتواند مستقیماً روی هزینه کسبوکار اثر بگذارد.
طبقهبندی تیکتهای پشتیبانی، استخراج اطلاعات از اسناد، تولید برچسب، تشخیص Intent، پردازش دستهای داده، Autocomplete، خلاصهسازی کوتاه و بسیاری از مراحل فرعی Agentها معمولاً به قویترین مدل بازار نیاز ندارند.
GPT-6 Luna؛ گزینه بسیار اقتصادی OpenAI
GPT-6 Luna مدل کمهزینهتر خانواده GPT-6 است. در حالت استاندارد و کانتکست کوتاه، قیمت API آن ۰٫۱۰ دلار برای هر یک میلیون توکن ورودی و ۰٫۵۰ دلار برای خروجی است؛ اختلافی چشمگیر نسبت به Astra و حتی Sol.
همین اختلاف نشان میدهد چرا معماریهایی که تمام درخواستها را به قویترین مدل میفرستند، معمولاً از نظر اقتصادی بهترین طراحی نیستند.
در یک سیستم حرفهای میتوان ابتدا درخواستهای ساده را به Luna سپرد و فقط زمانی که پیچیدگی مسئله بالا میرود، آنها را به مدل گرانتری ارجاع داد.
DeepSeek V4.1 Flash؛ تمرکز جدی روی نسبت قیمت به عملکرد
DeepSeek در ۱۰ سپتامبر ۲۰۲۶ V4.1 Flash را منتشر و مدل قبلی V4 Flash را بازنشسته کرد. نسخۀ جدید یک میلیون توکن کانتکست دارد، از حالتهای Thinking و Non-Thinking و ورودی تصویری پشتیبانی میکند و برای استفاده از طریق API با نام deepseek-flash ارائه میشود.
DeepSeek همچنان قیمتگذاری Peak و Off-Peak دارد. برای V4.1 Flash، ورودی بدون Cache بسته به ساعت استفاده ۰٫۱۵ یا ۰٫۳۰ دلار و خروجی ۰٫۶۰ یا ۱٫۲۰ دلار بهازای هر یک میلیون توکن هزینه دارد.
این نوع قیمتگذاری برای پردازشهای غیرلحظهای جالب است؛ چون سازمان میتواند بعضی Jobهای حجیم را به ساعات ارزانتر منتقل کند.
Mistral Small 4؛ مدلی باز با هزینۀ پایین
Mistral Small 4 در مارس ۲۰۲۶ با مجوز Apache 2.0 عرضه شد. این مدل ورودی متن و تصویر، ۲۵۶ هزار توکن کانتکست، قابلیت Reasoning قابل تنظیم و امکانات Agentic و کدنویسی را در یک مدل ترکیب میکند. قیمت API آن نیز ۰٫۱۵ دلار برای ورودی و ۰٫۶۰ دلار برای خروجی بهازای هر یک میلیون توکن است.
مزیت مهم Mistral Small 4 فقط قیمت API نیست؛ وزنهای آن نیز منتشر شدهاند. بنابراین برای سازمانهایی که اجرای مدل در زیرساخت خودشان اهمیت دارد، این گزینه جایگاه متفاوتی نسبت به سرویسهای کاملاً بسته پیدا میکند.
قیمت مدلهای هوش مصنوعی در سال ۲۰۲۶؛ تفاوتها چقدر است؟
جدول زیر بخشی از تفاوت قیمت API مدلهای مطرح را نشان میدهد. ارقام مربوط به هر یک میلیون توکن هستند و قیمت پلنهای مصرفکننده مانند ChatGPT Plus یا Claude Pro محسوب نمیشوند.
| مدل | نقش تقریبی | ورودی | خروجی |
|---|---|---|---|
| GPT-6 Astra | پرچمدار | ۱۰ دلار | ۵۰ دلار |
| Claude Opus 5.5 | پرچمدار | ۴ دلار | ۲۰ دلار |
| GPT-6 Sol | Workhorse | ۲ دلار | ۱۰ دلار |
| Claude Sonnet 5.5 | Workhorse | ۲ دلار | ۱۰ دلار |
| Grok 4.7 | Workhorse / Frontier | ۲ دلار | ۶ دلار |
| Gemini 3.8 Flash | Workhorse | ۰٫۷۵ دلار | ۳٫۷۵ دلار تا پایان ۲۰۲۶ |
| GPT-6 Luna | سبک | ۰٫۱۰ دلار | ۰٫۵۰ دلار |
| Mistral Small 4 | سبک / باز | ۰٫۱۵ دلار | ۰٫۶۰ دلار |
| DeepSeek V4.1 Flash | سبک | ۰٫۱۵ تا ۰٫۳۰ دلار | ۰٫۶۰ تا ۱٫۲۰ دلار |
این جدول یک واقعیت مهم را آشکار میکند: اختلاف قیمت میان مدلهای هوش مصنوعی میتواند دهها برابر باشد.
البته نباید فقط قیمت هر توکن را مقایسه کرد. مدلی که برای انجام یک کار دو برابر توکن مصرف میکند، ممکن است در نهایت از مدلی با قیمت اسمی بالاتر گرانتر تمام شود. Cache، Batch Processing، کانتکست طولانی، تعداد Tool Callها و میزان Retry نیز روی هزینه واقعی اثر میگذارند.
به همین دلیل معیار بهتر، Cost per completed task یا هزینه انجام موفق یک وظیفه است؛ نه فقط قیمت خام هر میلیون توکن.
دسته چهارم: مدلهای تخصصی؛ برای هر کاری سراغ LLM عمومی نروید
یکی از اشتباههای رایج هنگام انتخاب مدلهای هوش مصنوعی این است که تصور کنیم یک مدل زبانی عمومی باید تمام کارها را انجام دهد.
در سال ۲۰۲۶ ابزارهای تخصصی تصویر، ویدئو، صدا و موسیقی آنقدر پیشرفت کردهاند که در بسیاری از پروژهها بهتر است مستقیماً از مدل مناسب همان رسانه استفاده شود.
بهترین مدلهای هوش مصنوعی برای ساخت و ویرایش تصویر
در بخش تصویر، چند اکوسیستم مهم وجود دارد.
OpenAI در سپتامبر ۲۰۲۶ نسل GPT-Image-2.5 را معرفی کرد. در API، مدل Flare برای تولید و ویرایش سریع و باکیفیت روزمره در نظر گرفته شده و Sunburst روی دقت بیشتر در ویرایش و Workflowهای حرفهای تمرکز دارد.
Google نیز خانواده Nano Banana را گسترش داده است. Nano Banana 2 مدل عمومی این خانواده است، Nano Banana 2 Lite برای سرعت و هزینۀ پایینتر ساخته شده و Nano Banana Pro برای کارهای پیچیدهتر و تولید Asset حرفهای در نظر گرفته شده است. Google همچنین اعلام کرده مدلهای Imagen در Gemini API خاموش شدهاند و کاربران باید به Nano Banana مهاجرت کنند.
در سوی دیگر، Midjourney V8.2 از ژوئیه ۲۰۲۶ نسخۀ پیشفرض Midjourney است و این بهروزرسانی روی کیفیت بصری، زیباییشناسی، Personalization و مدل جدید ویرایش تمرکز دارد.
بنابراین برای تصویر هم چیزی به نام یک انتخاب مطلق وجود ندارد. نیاز به ویرایش دقیق یک تصویر موجود با نیاز به تولید Concept Art یا صدها Asset تبلیغاتی یکسان نیست.
بهترین مدلهای هوش مصنوعی برای تولید ویدئو
بازار ویدئوی مولد نیز در سال ۲۰۲۶ تغییر زیادی کرده است.
Google اکنون Gemini Omni Flash را بهعنوان گزینۀ پیشفرض خود برای تولید و ویرایش مکالمهای ویدئو معرفی میکند. این مدل میتواند در یک Workflow چندمرحلهای از متن، تصویر، صدا و ویدئو بهعنوان ورودی استفاده کند. برای کنترلهایی مثل گسترش صحنه، تعیین فریم ابتدا و انتها یا Workflowهای خاص، Veo 3.1 همچنان در دسترس است.
Veo 3.1 میتواند ویدئوی ۸ ثانیهای با صدای Native در رزولوشن 720p، 1080p یا 4K تولید کند و از حالت عمودی، تمدید ویدئو و تصاویر مرجع نیز پشتیبانی میکند.
xAI نیز برای تولید ویدئو Grok Imagine Video 1.5 و برای تصویر Imagine Image 2.0 را در مجموعۀ فعلی API خود قرار داده است.
در نتیجه، اگر هدف نهایی شما ویدئو است، الزاماً نباید ابتدا یک مدل زبانی انتخاب کنید و بعد دنبال راهی برای تبدیل پاسخ آن به ویدئو بگردید. مدل تخصصی مناسب میتواند مسیر بسیار کوتاهتری باشد.
مدلهای هوش مصنوعی برای صدا و موسیقی
Google در سپتامبر ۲۰۲۶ Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS را به مجموعۀ پایدار Gemini اضافه کرده است. اولی روی کیفیت و بیان صوتی و دومی روی سرعت و پردازش حجیم تمرکز دارد.
در زمینۀ موسیقی نیز Suno v6 در ۹ سپتامبر ۲۰۲۶ عرضه شد. خانواده جدید شامل v6، نسخۀ تجربیتر v6-wild و نسخۀ سریعتر v6-mini است و قابلیتهایی مانند ویرایش بخش مشخصی از آهنگ با زبان طبیعی، Mashup و استفاده همزمان از ورودیهای متنی، صوتی، تصویری و ویدئویی را ارائه میکند.
Google نیز Lyria 3.5 را در سپتامبر ۲۰۲۶ بهصورت عمومی عرضه کرده و قیمت API تولید یک آهنگ کامل را ۰٫۰۸ دلار بهازای هر درخواست اعلام کرده است.
اگر حفظ حریم خصوصی مهم است، سراغ مدلهای Open-Weight بروید
انتخاب مدل هوش مصنوعی فقط به کیفیت و قیمت API محدود نمیشود. گاهی دادههای سازمان آنقدر حساساند که ارسال آنها به یک سرویس ابری انتخاب مناسبی نیست؛ گاهی هم توسعهدهنده میخواهد مدل را Fine-tune کند یا بدون اتصال دائمی به اینترنت اجرا کند.
در این شرایط، مدلهای Open-Weight اهمیت پیدا میکنند.
یکی از گزینههای مهم سال ۲۰۲۶ Gemma 4 است. Google این خانواده را با مجوز Apache 2.0 و در اندازههای مختلف از E2B و E4B گرفته تا 12B، 26B A4B و 31B عرضه کرده است. مدلهای کوچکتر مشخصاً برای اجرا روی لپتاپ و حتی سختافزارهای Edge طراحی شدهاند، در حالی که نسخههای بزرگتر برای Workstation و Server مناسبتر هستند. Gemma 4 بسته به نسخه از متن، تصویر و در برخی مدلها صوت پشتیبانی میکند و تا ۲۵۶ هزار توکن کانتکست دارد.
Mistral Small 4 هم با مجوز Apache 2.0 و وزنهای در دسترس، گزینۀ دیگری برای استقرار خصوصی است، هرچند اجرای کامل آن نسبت به مدلهای کوچک Gemma سختافزار بسیار قویتری میخواهد.
DeepSeek نیز وزنهای خانواده V4 را منتشر کرده است و از این نظر در جمع گزینههای باز برای استقرارهای سفارشی قرار میگیرد.
بنابراین اگر حریم خصوصی اولویت اصلی است، بهتر است سؤال را از «کدام API ارزانتر است؟» به «چه مدلی را میتوانم تحت کنترل خودم اجرا کنم؟» تغییر دهید.
برای هر کاربرد کدام مدل هوش مصنوعی را انتخاب کنیم؟
حالا به بخش عملی ماجرا میرسیم. قرار نیست برای انتخاب مدل، دهها بنچمارک را حفظ کنید. کافی است مسئله را درست تعریف کنید.
| نیاز | نقطۀ شروع منطقی |
|---|---|
| نوشتن، ویرایش و کارهای حرفهای روزمره | GPT-6 Sol، Claude Sonnet 5.5 یا Gemini 3.8 Flash |
| مسئله پیچیده و چندمرحلهای | GPT-6 Astra یا Claude Opus 5.5 |
| کدنویسی روزمره و رفع باگ | Claude Sonnet 5.5، GPT-6 Sol، Gemini 3.8 Flash یا Grok 4.7 |
| Agentهای پیچیده و طولانی | مدل Workhorse را ابتدا تست کنید؛ فقط در صورت نیاز به Opus/Astra ارتقا دهید |
| پردازش انبوه و اتوماسیون | GPT-6 Luna، DeepSeek V4.1 Flash یا Mistral Small 4 |
| اسناد بسیار طولانی و ورودی چندرسانهای | Gemini 3.8 Flash |
| اجرای محلی و خصوصی | Gemma 4 یا Mistral Small 4 |
| تولید و ویرایش تصویر | GPT-Image-2.5، Nano Banana 2/Pro یا Midjourney V8.2 |
| تولید ویدئو | Gemini Omni Flash یا Veo 3.1 |
| تولید موسیقی | Suno v6 یا Lyria 3.5 |
این جدول قرار نیست حکم قطعی صادر کند. نقطۀ شروع میدهد. پس از آن باید دو یا سه مدل هوش مصنوعی را با نمونههای واقعی خودتان آزمایش کنید.
برای مثال، اگر کار شما تولید محتواست، پنج متن واقعی قبلی، یک Brand Guideline و چند Task رایج را در اختیار مدلهای مختلف قرار دهید و خروجیها را از نظر لحن، دقت، نیاز به ویرایش، سرعت و هزینه مقایسه کنید. چنین آزمونی برای شما بسیار ارزشمندتر از اختلاف چند درصدی دو مدل در بنچمارکی است که ارتباط مستقیمی با کارتان ندارد.
یک روش بهتر: Routing بهجای انتخاب فقط یک مدل
یکی از مهمترین تغییرات در نحوۀ استفاده از مدلهای هوش مصنوعی این است که دیگر لازم نیست کل محصول یا Workflow خود را به یک مدل وابسته کنید.
فرض کنید یک Agent پشتیبانی دارید. درخواستهایی مثل تشخیص زبان، طبقهبندی موضوع و استخراج شماره سفارش را میتوان به یک مدل سبک سپرد. اگر مشتری سؤال پیچیدهتری داشت، درخواست میتواند به مدل Workhorse منتقل شود. فقط موارد بسیار دشوار یا مبهم لازم است به مدل پرچمدار برسند.
همین ساختار در تولید محتوا هم قابل استفاده است. استخراج داده و دستهبندی منابع را مدل ارزان انجام دهد، نگارش اولیه به مدل Workhorse سپرده شود و یک مدل قویتر فقط برای تحلیل عمیق، ارزیابی استراتژی یا حل تناقض میان منابع وارد Workflow شود.
نتیجه معمولاً سیستمی است که هم هزینه کمتری دارد و هم منابع محاسباتی را منطقیتر مصرف میکند.
در واقع سؤال حرفهای سال ۲۰۲۶ شاید دیگر «کدام مدل را انتخاب کنم؟» نباشد؛ بلکه این باشد که هر بخش از کارم را به کدام مدل بسپارم؟
هنگام مقایسه مدلهای هوش مصنوعی به این ۶ معیار توجه کنید
اولین معیار، کیفیت روی وظیفۀ واقعی شما است. مدلها را با Prompt و دادههای واقعی کسبوکارتان مقایسه کنید، نه فقط مثالهای نمایشی شرکت سازنده.
معیار دوم هزینه انجام کامل کار است. قیمت هر توکن تنها یکی از عوامل است؛ تعداد توکن خروجی، Retry، Tool Call، Cache و مدت اجرای Agent نیز هزینه ایجاد میکنند.
معیار سوم سرعت است. در یک ابزار داخلی شاید چند ثانیه تأخیر مهم نباشد، اما در چت آنلاین، Autocomplete یا Voice Agent میتواند تجربه کاربر را خراب کند.
چهارمین معیار کانتکست و نوع ورودی است. اگر با صدها صفحه سند، فایل صوتی، تصویر یا ویدئو کار میکنید، پشتیبانی Multimodal و Context Window اهمیت بسیار بیشتری پیدا میکند.
پنجمین معیار ابزارها و اکوسیستم است. قابلیت Web Search، Code Execution، File Search، Computer Use، Function Calling و Connectorها میتواند گاهی مهمتر از قدرت خام خود مدل باشد.
و در نهایت باید حریم خصوصی و امکان استقرار را بررسی کرد. برای بعضی سازمانها، مدل Open-Weight که روی سرور داخلی اجرا میشود حتی اگر اندکی ضعیفتر باشد، انتخاب مناسبتری از یک API ابری قدرتمند است.
آیا همیشه جدیدترین مدل هوش مصنوعی انتخاب بهتری است؟
نه لزوماً.
عرضه یک مدل جدید به این معنی نیست که همان لحظه باید تمام Workflowهای موجود را به آن منتقل کنید. مدل جدید ممکن است رفتار متفاوتی در Prompt Following داشته باشد، Token Usage آن تغییر کرده باشد یا نتیجه برخی وظایف تخصصی شما با نسخۀ قبلی سازگار نباشد.
حتی وضعیت Stable یا Preview نیز مهم است. برای مثال Gemini 3.8 Flash در حال حاضر Stable و آماده Production است، در حالی که Gemini 3.1 Pro همچنان Preview محسوب میشود.
بهتر است قبل از مهاجرت، مجموعهای از Regression Testهای واقعی داشته باشید و نسخۀ جدید را روی همان ورودیها اجرا کنید.
آیا مدل پرچمدار همیشه خروجی بهتری میدهد؟
برای دشوارترین وظایف، احتمال آن بیشتر است؛ اما برای بسیاری از کارهای ساده تفاوت آنقدر نیست که هزینۀ بیشتر را توجیه کند.
اگر یک مدل ۵۰ دلاری برای هر میلیون توکن خروجی و یک مدل ۰٫۵ دلاری بتوانند یک عملیات طبقهبندی ساده را با دقت مورد نیاز شما انجام دهند، استفاده از مدل گرانتر مزیت خاصی ندارد.
مدل پرچمدار باید جایی استفاده شود که توانایی بیشتر آن واقعاً ارزش اقتصادی ایجاد کند.
آیا مدلهای ارزان برای تولید محتوا کافی هستند؟
برای بعضی مراحل بله، برای همۀ مراحل نه.
مدلهای سبک میتوانند برای استخراج Keyword، ساخت Tag، طبقهبندی محتوا، تبدیل فرمت، خلاصهسازی ساده یا پردازش تعداد زیادی رکورد بسیار مناسب باشند.
اما نگارش یک مقالۀ تخصصی، تحلیل Tone of Voice، ترکیب چند منبع متناقض یا تدوین استراتژی محتوا معمولاً از مدل Workhorse یا در موارد سختتر از یک مدل پرچمدار سود بیشتری میبرد.
بهترین Workflow لزوماً استفاده از یک مدل نیست؛ میتواند ترکیبی از چند مدل هوش مصنوعی باشد.
برای استفاده شخصی باید قیمت API را بررسی کنیم؟
نه همیشه.
قیمتهایی که در این مقاله مطرح شدهاند مربوط به API هستند و برای توسعهدهندگان و کسبوکارهایی اهمیت بیشتری دارند که مدل را داخل محصول یا اتوماسیون خود استفاده میکنند.
اگر فقط از ChatGPT، Claude، Gemini یا ابزارهای مشابه از طریق رابط کاربری استفاده میکنید، باید محدودیتها و قیمت پلن اشتراکی همان سرویس را بررسی کنید. قیمت API و اشتراک ماهانه دو موضوع متفاوتاند.
سخن پایانی؛ در سال ۲۰۲۶ «بهترین مدل» وجود ندارد، بهترین انتخاب وجود دارد
بازار مدلهای هوش مصنوعی در سال ۲۰۲۶ به نقطهای رسیده که انتخاب براساس نام برند یا یک جدول بنچمارک دیگر کافی نیست.
GPT-6 Astra و Claude Opus 5.5 برای دشوارترین کارها ساخته شدهاند، اما احتمالاً لازم نیست تمام درخواستهای روزمره به آنها فرستاده شود. مدلهایی مثل GPT-6 Sol، Claude Sonnet 5.5، Gemini 3.8 Flash و Grok 4.7 میتوانند بخش بزرگی از کارهای حرفهای را پوشش دهند. برای پردازش حجیم، گزینههایی مانند GPT-6 Luna، DeepSeek V4.1 Flash و Mistral Small 4 هزینه را بهشدت کاهش میدهند. برای تصویر، ویدئو و موسیقی نیز مدلهای تخصصی اغلب انتخاب منطقیتری هستند.
اگر اجرای خصوصی مهم باشد، گزینههای Open-Weight مانند Gemma 4 و Mistral Small 4 مسیر دیگری پیش روی شما قرار میدهند.
بنابراین قبل از انتخاب مدل هوش مصنوعی، سه سؤال از خودتان بپرسید: کار من چقدر پیچیده است؟ حجم استفاده چقدر خواهد بود؟ و یک پاسخ بهتر واقعاً چقدر برای من ارزش دارد؟
بعد از پاسخ به این سؤالها، انتخاب میان دهها اسم و نسخه جدید بسیار سادهتر میشود.
و مهمتر از همه، به یک مدل وابسته نشوید. سرعت تغییر این بازار آنقدر زیاد است که نام مدلهای برتر ممکن است چند ماه دیگر دوباره عوض شود؛ اما اگر بدانید برای هر نوع کار باید دنبال چه ویژگیهایی بگردید، با ورود نسل بعدی مدلهای هوش مصنوعی هم میتوانید خیلی سریع انتخاب درستتری داشته باشید.